| Код |
a^b |
С операторами:
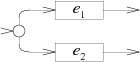
"|"
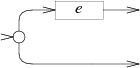
"?"
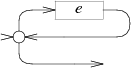
"*"
"+"
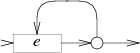
все просто и понятно, а вот как быть с оператором "^"?
В гугле пусто, т.к. корректно сформулировать вопрос так и не удалось(NFA operator ^, NFA operator not, NFA ^)???
| Версия для печати темы
Нажмите сюда для просмотра этой темы в оригинальном формате |
| Форум программистов > Алгоритмы > Регулярное выражение, оператор "not" в NFA |
| Автор: rudvil 25.7.2010, 15:04 | ||
Как в регулярных выражениях выглядит NFA для оператора "^"?
С операторами: "|" "?" "*" "+" все просто и понятно, а вот как быть с оператором "^"? В гугле пусто, т.к. корректно сформулировать вопрос так и не удалось(NFA operator ^, NFA operator not, NFA ^)??? |
| Автор: Pavia 25.7.2010, 17:12 | ||||
В таблице состояний отрицательное и положительное меняется местами.
А никак, тут для упрощение отрицательные состояния не показаны. И вообще оператор ^ обычно применяется только в "[]" скобках. |
| Автор: rudvil 25.7.2010, 17:35 | ||
первый раз слышу, пошел гуглить... все равно, спасибо. |
| Автор: Pavia 25.7.2010, 18:31 | ||
Гугл тебя думать не научит. |
| Автор: neutrino 25.7.2010, 18:46 | ||
| Вот так думаю все станет понятно: a(∑\{b}) Когда ∑ обозначает весь алфавит: ∑={a..z}U{0..9}U{@#$%^&*...} Добавлено через 4 минуты и 56 секунд
Это лишено всякого смысла, ибо если а, то уж точно не б. Видимо имеется в виду: а, а потом все кроме б. Именно для этого случая я написал пояснение. |
| Автор: esperanto 25.7.2010, 22:36 |
| Правильный ответ: 1) Имея НФА, строишь ДФА ему эквивалентный 2) Имея ДФА строишь его отрицание, посредством инверсии конечных состояний. 3) Полученный ДФА он же и НФА и есть нот от исходного автомата |
| Автор: neutrino 27.10.2010, 15:16 |
| esperanto, А побыстрее никак? |
| Автор: rudvil 27.10.2010, 23:40 |
Чтобы упростить я остановился на решении как тут http://www.codeproject.com/KB/recipes/re_expression_parser.aspx т.е. если попали на dummy то дальше идти не будем. |
| Автор: esperanto 28.10.2010, 14:47 | ||
На курсе, вычислений учили именно так делать. Я не видел других решений в учебниких никогда. |
| Автор: neutrino 28.10.2010, 16:30 |
| rudvil, Да, но если мне нужно построить не отрицание одного символа, а отрицание целого регулярного выражения, то такой фокус не пройдет. Добавлено через 54 секунды Кстати, за ссылку спасибо. Интересно было почитать. Жаль я не читал ее до того, как реализовал свой регексп. |
| Автор: neutrino 2.11.2010, 21:49 |
| esperanto, У меня не получилось реализовать такой вариант. Вот посмотри на этот регексп комментария в С например: "/*"(^("*/"))*"*/" Здесь я выделил операторы красным. ^ - отрицание. * - Kleene closure (хрен знает как по-русски, ну сколько угодно повторений включая 0). Скобки задают приоритеты операторов. Можно прочитать этот регексп как: "/*"; все, что угодно кроме "*/"; "*/". Именно так задают подобные токены в Лексе и подобных тулах. Нарисуй или опиши мне автомат, который принимает комментарии. Внимание! До комментария и после идут другие токены, т.е. мне необходим именно такой автомат, который бы мне нарезал ввод на токены, один из которых - комментарий. |
| Автор: rudvil 2.11.2010, 23:29 | ||||
Не совсем верное рег. выражение. Тут можно почитать про более универсальный регэксп http://ostermiller.org/findcomment.html
|
| Автор: esperanto 2.11.2010, 23:35 | ||
В формальном определение регулярных выражений нет операции отрицание. Отрицание можно применить на язык распозноваемый регулярным выражением. Замыкание Клина наверное это называется |
| Автор: neutrino 3.11.2010, 00:53 |
| Известно, что регулярные языки можно инвертировать и получить регулярный язык. В данном случае регулярное выражение - пример нотации. Дело в принципе. Как можно автомат такой создать? |
| Автор: esperanto 4.11.2010, 10:03 |
| Тогда наверное так Разбираем регулярное выражение. Находим терм содержащий отрицание. Переводим его в автомат, для автомата строим отрицание, и ответ переводим в регулярное выражение. это регулярное выражение подставляем вместо терма и так продолжаем Сложность экспоненциальная. |
| Автор: neutrino 4.11.2010, 12:27 |
| Да, но в конце концов мне нужен автомат, а не регексп. Думаю решение лежит где-то в области lookeahead-а, причем отрицательного. Т.е. когда я хочу найти токен, в котором нет "*/" (как в регекспе выше), то мне нужно матчить все у чего есть отрицательный lookahead "*/". Прикол еще ведь в том, что когда я сожрал "*/" и понял, что нужно вернуть токен до "*/", то я делаю как-бы откат назад. Как раз lookahead тут должен разрешить ситуацию. Добавлено через 4 минуты и 54 секунды rudvil, Не понятно к чему такой пост. Здесь мы разбираем теорию, а не занимаемся поиском наиболее точного регекспа. И если уж вы идете в этом направлении, то гораздо проще использовать т.н. lazy quantification, частности non-greedy quantifier. |
