
 |
|
Модераторы: Daevaorn |
 

|
|
 Распределённые вычисления, Какое железо выбрать?

| KaraKum |
|
|||
|
Опытный  Профиль Группа: Участник Сообщений: 640 Регистрация: 3.12.2007 Репутация: 1 Всего: 1 |
Доброе время суток.
Пишу программу на С++ где есть поле для ускорения вычислений (которые сейчас длятся сутками (по 24 часа которые)) в разбиении выполнения на потоки, при этом потоков может быть очень много (найдётся работа для тысяч потоков). Специфика программы в следующем: - используемых данных довольно-таки мало (100 килобайт от-силы (на несколько часов работы)) - то есть их можно передать по сети - каскадное разбиение на подзадачи (потоки) - разбив задачу на какие-то части, получившиеся части (подзадачи) можно также разбить на другие - процесс вычисления проходит практически без использования оперативной памяти (меньше одного мегабайта) Так вот вопрос в следующем: какое железо лучше всего подойдёт для осуществления параллельных вычислений для этой задачи? Гипер-современные (и соответственно дорогие) якобы 8-ми ядерные Core-i7; старые дешёвые (1000 рублей за штуку) однопоточные Celeron'ы с 4ГГц тактовой частоты?; видеокарты от NVidia (GeForce, Tesla) - придётся использовать чуждую мне "CUDA"; ... Что посоветуете? |
|||
|
||||
 Дата 13.12.2010, 13:06 (


 Загрузка ...


| Sartorius |
|
|||
 Эксперт Профиль Группа: Завсегдатай Сообщений: 1568 Регистрация: 18.7.2006 Где: Ivory tower Репутация: 8 Всего: 37 |
Если памяти много на каждую подзадачу не требуется, то ИМХО нет смысла использовать кластеры и т.п. GPU вполне подходит для подобной задачи.
|
|||
|
||||

| KaraKum |
|
|||
|
Опытный Профиль Группа: Участник Сообщений: 640 Регистрация: 3.12.2007 Репутация: 1 Всего: 1 |
GPU от NVidia с использованием CUDA?
|
|||
|
||||
| Artemon |
|
|||
|
а ты мне нравишься Профиль Группа: Завсегдатай Сообщений: 1771 Регистрация: 24.2.2004 Где: Челябинск Репутация: 1 Всего: 20 |
Если обработка твоих данных не зависит от передыдующих данных, то CUDA, думаю справится быстрее всех предложенных тобой решений.
Поясню: например есть задача размыть изображение. Данная задача заключается в том, чтобы каждый пиксель обработать определенным алгоритмом. Так вот CUDA может каждый пиксель обработать одновременно (к сожалению забыл, сколько параллельных операций может сделать CUDA, но что-то в районе нескольких тысяч). -------------------- Контроль топлива на топливозаправщиках, мониторинг автотранспорта, расчет зарплаты водителей www.rscat.ru |
|||
|
||||
| Sartorius |
|
|||
|
Эксперт Профиль Группа: Завсегдатай Сообщений: 1568 Регистрация: 18.7.2006 Где: Ivory tower Репутация: 8 Всего: 37 |
CUDA или OpenCL на выбор. Или XBox/ PlayStation. Один товарищь на 10 PS терафлопсный кластер дома собрал )) |
|||
|
||||

| borisbn |
|
|||
 Эксперт Профиль Группа: Завсегдатай Сообщений: 4875 Регистрация: 6.2.2010 Где: Ростов-на-Дону Репутация: 22 Всего: 135 |
CUDA - привязка к nVidia (не худшая, конечно, но всё-таки привязка). Советую посмотреть на OpenCL, т.к. он поддерживается и nVidia и ATI и, если не ошибаюсь, Intel. Т.е. ты сможешь спокойно (почти) менять видеокарточки и даже выполнять вычисления без оных. А что за вычисления, если не секрет ? Может можно их оптимизировать и на ЦП ? Например при помощи Intel® Integrated Performance Primitives или Intel® Threading Building Blocks -------------------- Женщины отличаются от программистов тем, что у них чары состоят из стрингов |
|||
|
||||

| KaraKum |
|
|||
|
Опытный Профиль Группа: Участник Сообщений: 640 Регистрация: 3.12.2007 Репутация: 1 Всего: 1 |
Универское задание по симулированию молекулярных (межатомных) взаимодействий в жидкости, упругих и аморфных телах и так далее... Целью задачи является сбор статистики нестандартных явлений (гравитационный резонанс, испускание нейтрона...), поэтому эту задачу можно разбить на потоки вот так: каждый элемент проявляет воздействие (гравитационное, сильное/слабое ядерное, электромагнитное) на каждый другой, изменяя состояние оного, а тот, впоследствии, также проявляется воздействие на каждый другой и так далее - воздействие каждого элемента на все другие можно разбить по потокам и выполнять параллельно, лишь периодически синхронизируя. Один элемент - это 4-10 float-овых значений - не проблема передать даже по Dial-Up модему. Вот мой компьютер (2-х ядерный Интел) 10 элементов симулирует за 2 секунды, 56 элементов за 250 секунд, а 1021 элемент симулирует уже вторые сутки  Проблема в том что для совершения последующего шага требует знания состояния предыдущего шага и так далее (то есть, например, конечное состояние системы (мира) нельзя вычислить по формуле как это делается, к примеру, в уравнении координаты точки s=v*t + a*t^2 ) А что можете сказать по поводу распределения вычислений по сети? Клиенты подключаются к серверу и "предлагают" ему свою вычислительную помощь - сервер передаёт какую-то порцию работы. Есть какие-то библиотеки в этой области? Чтобы не решать заново уже решённое - ожидание ответа (торможение всех остальных) от отключившихся клиентов; подхватывание только что подключившихся на-лету и так далее... |
|||
|
||||
| boostcoder |
|
|||
 pattern`щик Профиль Группа: Завсегдатай Сообщений: 5458 Регистрация: 1.4.2010 Репутация: 49 Всего: 110 |
||||
|
||||
| Sartorius |
|
||||
|
Эксперт Профиль Группа: Завсегдатай Сообщений: 1568 Регистрация: 18.7.2006 Где: Ivory tower Репутация: 8 Всего: 37 |
В мол. динамике учитывают только электромагнитные взаимодействия. Остальные не имеет смысла обсчитывать в этом маштабе. PS Посмотрите исходники громакса www.gromacs.org. Там грамотно параллелится такой счет. AFAIK для счета GPU там тоже есть порт. Это сообщение отредактировал(а) Sartorius - 13.12.2010, 18:50 |
||||
|
|||||
| W4FhLF |
|
|||
 found myself Профиль Группа: Участник Клуба Сообщений: 2831 Регистрация: 2.12.2006 Репутация: 20 Всего: 121 |
KaraKum, насколько я понял твоя задача похожа на пресловутую n-body problem, которая очень хорошо распараллеливается в целом и в рамках подходов связанных с вычислениями на GPU тоже, тем более ты используешь вычисления одинарной точности. В СДК ещё с самых первых версий лежит пример решения этой задачи.
Вот производительность при решении этой задачи для 107520 объектов. Но тут двойная точность, для одинарной разрыв с обычным процессором был бы гораздо больше, на порядок. 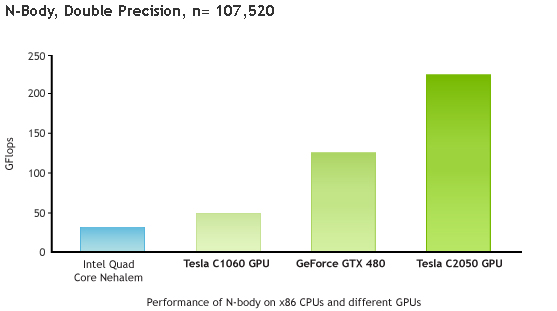
Вот так может говорить только человек, который никогда ни с одной из этих библиотек не работал. Без обид.Если кратко, то если не хочешь лишнего секса с дровами/совместимостью/пробелами в стандарте/отсутствием норм. доков и кода, то выбирай CUDA. Плюс OpenCL из-за своей универсальности всегда будет медленнее CUDA. Хотя если интерес чисто академический, то почему бы и нет. -------------------- "Бог умер" © Ницше "Ницше умер" © Бог |
|||
|
||||

| KaraKum |
|
|||
|
Опытный Профиль Группа: Участник Сообщений: 640 Регистрация: 3.12.2007 Репутация: 1 Всего: 1 |
О, спасибо за столь развёрнутый ответ!
Тогда такой немного отстранённый от основной темы вопрос про CUDA в контексте моей задачи: - будет ли работать CUDA-код на одноядерном процессоре вообще без видеокарт? - CUDA - это хоть немного похоже на "pthread" - то есть код примерно следующего (если говорить в-общем) типа не придётся полностью принципиально переписывать?:
- будет ли CUDA-код хотя бы компилироваться для Линукса? (кроссплатформенность бывает узкой, вот, например, в случае с PhysX (тоже от NVidia) в Линуксе не поддерживает мягкие ткани (удивительно!) и полностью отсутствует 64-битная версия) |
|||
|
||||
| W4FhLF |
|
||||
|
found myself Профиль Группа: Участник Клуба Сообщений: 2831 Регистрация: 2.12.2006 Репутация: 20 Всего: 121 |
KaraKum, CUDA это библиотека. А код написанный под GPU на обычном процессоре работать не будет. Там свой компилятор и свой машинный код. Но программу ты пишешь на С/С++. Лучше то конечно почитать что-нибудь, я же тут не стану тебе цитировать документацию.
да спокойно вообще, CUDA есть под линукс, вин, макось. Просто ставишь дрова, рантайм и поехало. Добавлено @ 18:17
Концептуально идея таже, но там масса своих деталей. переписывать думаю придётся Это сообщение отредактировал(а) W4FhLF - 17.12.2010, 18:17 -------------------- "Бог умер" © Ницше "Ницше умер" © Бог |
||||
|
|||||
| Фантом |
|
|||
 Вы это прекратите! Профиль Группа: Участник Клуба Сообщений: 1516 Регистрация: 23.3.2008 Репутация: нет Всего: 49 |
А это прямое суммирование или tree-code? |
|||
|
||||
| W4FhLF |
|
|||
|
found myself Профиль Группа: Участник Клуба Сообщений: 2831 Регистрация: 2.12.2006 Репутация: 20 Всего: 121 |
Фантом, полагаю, что прямое суммирования раз оно эффективно работает на ГПУ
Но я не уверен. Это сообщение отредактировал(а) W4FhLF - 17.12.2010, 19:23 -------------------- "Бог умер" © Ницше "Ницше умер" © Бог |
|||
|
||||
| KaraKum |
|
|||
|
Опытный Профиль Группа: Участник Сообщений: 640 Регистрация: 3.12.2007 Репутация: 1 Всего: 1 |
Пока ждал первого ответа на свой вопрос решил делать упор на распределённые вычисления, организованные через WWW на компьютерах друзей и знакомых - набралось уже 20 компьютеров (разношёрстной "публики" - от Pentium III до Xeon-сервера и от DOS до Linux - ужас). (DOS, кстати, в интернет-то выйти может?). Ещё сделал не всё но что-то запускаемое есть: прога на клиенте добавляется в автозапуск; при старте компа подключается ко мне (в "центр"), получает задание, выполняет его и отправляет результат мне; потребляет на клиенте не всю мощность процессора (чтобы пользователь не жаловался на то что у него мышка по экрану еле ползает) (правда не научился как сделать зависимость от мощности процессора); и так далее... Что рассказываю-то: вот и не знаю как сюда впишется CUDA - конечно можно забыть про CUDA вообще и развивать всё уже по намеченной траектории, но всё-таки обидно "махнуть рукой" на ЭВМ, у которых есть GPU от NVidia, но не работает на меня  Это сообщение отредактировал(а) KaraKum - 17.12.2010, 19:56 |
|||
|
||||
| Фантом |
|
|||
|
Вы это прекратите! Профиль Группа: Участник Клуба Сообщений: 1516 Регистрация: 23.3.2008 Репутация: нет Всего: 49 |
Э, нет, так я и сам могу.  Собственно, мне именно это и хочется узнать, поскольку, если это прямое суммирование, то такой результат понятен, но (по крайней мере для меня) неинтересен. А вот если на GPU удалось выжать такой прирост производительности для tree-кода, то это уже совсем другое дело. |
|||
|
||||
| W4FhLF |
|
|||
|
found myself Профиль Группа: Участник Клуба Сообщений: 2831 Регистрация: 2.12.2006 Репутация: 20 Всего: 121 |
-------------------- "Бог умер" © Ницше "Ницше умер" © Бог |
|||
|
||||
| Фантом |
|
|||
|
Вы это прекратите! Профиль Группа: Участник Клуба Сообщений: 1516 Регистрация: 23.3.2008 Репутация: нет Всего: 49 |
Спасибо, посмотрел. Увы, но пока это лишь прямое суммирование, причем предельно простое - с интегрированием методом Эйлера и регуляризацией путем обрезки потенциала. Все остальное только "в будущем мы предполагаем рассмотреть...". А жаль. |
|||
|
||||
| W4FhLF |
|
||||
|
found myself Профиль Группа: Участник Клуба Сообщений: 2831 Регистрация: 2.12.2006 Репутация: 20 Всего: 121 |
Это где?
Дык примеру то сколько лет?) Я немного поискал, уже кое-что сделано. Погугли: Toward efficient GPU-accelerated N-body simulations A novel multiple-walk parallel algorithm for the Barnes–Hut treecode on GPUs – towards cost effective, high performance N-body simulation Accelerating astrophysical particle simulations with programmable hardware (FPGA and GPU) High Performance Direct Gravitational N-body Simulations on Graphics Processing Units The Chamomile Scheme: An Optimized Algorithm for N-body simulations on Programmable GPUs -------------------- "Бог умер" © Ницше "Ницше умер" © Бог |
||||
|
|||||
| Фантом |
|
||||
|
Вы это прекратите! Профиль Группа: Участник Клуба Сообщений: 1516 Регистрация: 23.3.2008 Репутация: нет Всего: 49 |
П.31.2, две последние формулы (с приближенными равенствами).
Да я знаю. Проблема в том, как это сделано - эти вещи почти всегда эффективны на синтетических тестах, а в реальных задачах производительность очень серьезно падает. Именно поэтому первый вопрос и возник - "а вдруг"? Либо я все-таки что-то пропустил, либо кто-то все-таки что-то хорошее придумал. |
||||
|
|||||
| W4FhLF |
|
||||
|
found myself Профиль Группа: Участник Клуба Сообщений: 2831 Регистрация: 2.12.2006 Репутация: 20 Всего: 121 |
А, это ты про защиту от деления на ноль...
А чем эти тесты от реальных задач отличаются? -------------------- "Бог умер" © Ницше "Ницше умер" © Бог |
||||
|
|||||
| Фантом |
|
||||
|
Вы это прекратите! Профиль Группа: Участник Клуба Сообщений: 1516 Регистрация: 23.3.2008 Репутация: нет Всего: 49 |
Не совсем. Точнее, про это, но это не защита от деления на ноль. Вероятность точно попасть одним телом в другое ничтожно мала, так что формально ничего никуда не выпадет... только результат будет неправильным - из-за очень быстрого изменения скоростей при тесных сближениях, при котором достаточный в обычных случаях шаг интегрирования будет слишком большим.
Параметрами тел, их распределением, характерными интервалами времени, на которых надо считать... Ну вот те же тесные сближения: если сначала расположить все точки равномерно и считать все на временах, меньших времени пересечения, то код получится очень эффективным - из-за практически постоянного распределения точек по дереву поиска. |
||||
|
|||||
| W4FhLF |
|
|||
|
found myself Профиль Группа: Участник Клуба Сообщений: 2831 Регистрация: 2.12.2006 Репутация: 20 Всего: 121 |
Фантом, ясно, спасибо за небольшой экскурс. ;)
-------------------- "Бог умер" © Ницше "Ницше умер" © Бог |
|||
|
||||
| KaraKum |
|
|||
|
Опытный Профиль Группа: Участник Сообщений: 640 Регистрация: 3.12.2007 Репутация: 1 Всего: 1 |
Насколько я знаю, нет стандартного метода потреблять только определённый процент производительности процессора, правильно ли я предполагаю что следует в коде расставить вызовы "sleep()", в которые передавать время, зависящее от мощности компа чем слабее комп, тем больше время "отдыха". Однако как можно определить такую абстрактную характеристику как "мощность"? Может есть уже какие-то реализованные средства? Или писать что-то типа?:
бррр.... Что по этому поводу можете посоветовать? Ато даже не знаю с чего начать поиски... |
|||
|
||||
| xvr |
|
|||
|
Эксперт Профиль Группа: Комодератор Сообщений: 7046 Регистрация: 28.8.2007 Где: Дублин, Ирландия Репутация: 60 Всего: 223 |
А вызов sleep в произвольные моменты времени может только ухудшить общую производительность системы, т.к. большую часть времени процессор будет занять переключениями задач (на вашу задачу и обратно), а не полезной работой |
|||
|
||||
| KaraKum |
|
|||
|
Опытный Профиль Группа: Участник Сообщений: 640 Регистрация: 3.12.2007 Репутация: 1 Всего: 1 |
Да - это вроде подходит... А что по поводу общих характеристик о производительности компьютера? Это всё-равно нужно для того чтобы выделять задачи с размером в зависимости от мощности компьютера. |
|||
|
||||
| xvr |
|
|||
|
Эксперт Профиль Группа: Комодератор Сообщений: 7046 Регистрация: 28.8.2007 Где: Дублин, Ирландия Репутация: 60 Всего: 223 |
 |
|||
|
||||
| KaraKum |
|
|||
|
Опытный Профиль Группа: Участник Сообщений: 640 Регистрация: 3.12.2007 Репутация: 1 Всего: 1 |
Это очень неопределённо: решил складывать все подключенные процессоры и каждому клиенту выдавать задачу в зависимости от доли его процессоров в общей совокупности (тоже самое и с тактовой частотой) - то есть чем больше у него процессоров и тактовой частоты - тем больше задач он получит. Для корректировки этого значения собираюсь хранить статистику выполнения задач в базе данных и если при распределении задач имеется уже какая-то статистика для именно этого процессора, то давать ему задачу исходя из его "репутации". Как это смотрится со стороны?  P.S. Спрашиваю потому что иногда при поиске решения мозг как-то зацикливается на одном и том же и перестаёт видеть порой простые и красивые решения... |
|||
|
||||
| xvr |
|
|||
|
Эксперт Профиль Группа: Комодератор Сообщений: 7046 Регистрация: 28.8.2007 Где: Дублин, Ирландия Репутация: 60 Всего: 223 |
В принципе нормально ...
|
|||
|
||||


|
|
| Правила форума "С++:Общие вопросы" | |
|
|
Добро пожаловать!
Если Вам понравилась атмосфера форума, заходите к нам чаще! С уважением, Earnest Daevaorn |
| 0 Пользователей читают эту тему (0 Гостей и 0 Скрытых Пользователей) | |
| 0 Пользователей: | |
| « Предыдущая тема | C/C++: Общие вопросы | Следующая тема » |
[ Время генерации скрипта: 0.0764 ] [ Использовано запросов: 22 ] [ GZIP включён ]
Реклама на сайте Информационное спонсорство
|
|
По вопросам размещения рекламы пишите на vladimir(sobaka)vingrad.ru
Отказ от ответственности Powered by Invision Power Board(R) 1.3 © 2003 IPS, Inc. |